Writing2026-10-20
AI 项目验收:这八类错误最容易被忽略
很多 AI 项目上线后才发现数据不对——不是报错,而是悄悄算错。幂等、越权、离线恢复、边界值……这八类静默失败必须提前测。
喜欢 0阅读 66
欢迎来到晓黎团队博客
加载中...
AI 项目上线后最伤的不是报错——报错有告警、有人处理。真正伤的是不报错的错:数据悄悄算错、结果悄悄变差、成本悄悄翻倍。等发现时,错误的输出已经被当成正确的使用了很久。
验收阶段要把这些静默失败提前逼出来。以下八类,是我们复盘过的 AI 项目里出现频率最高的。
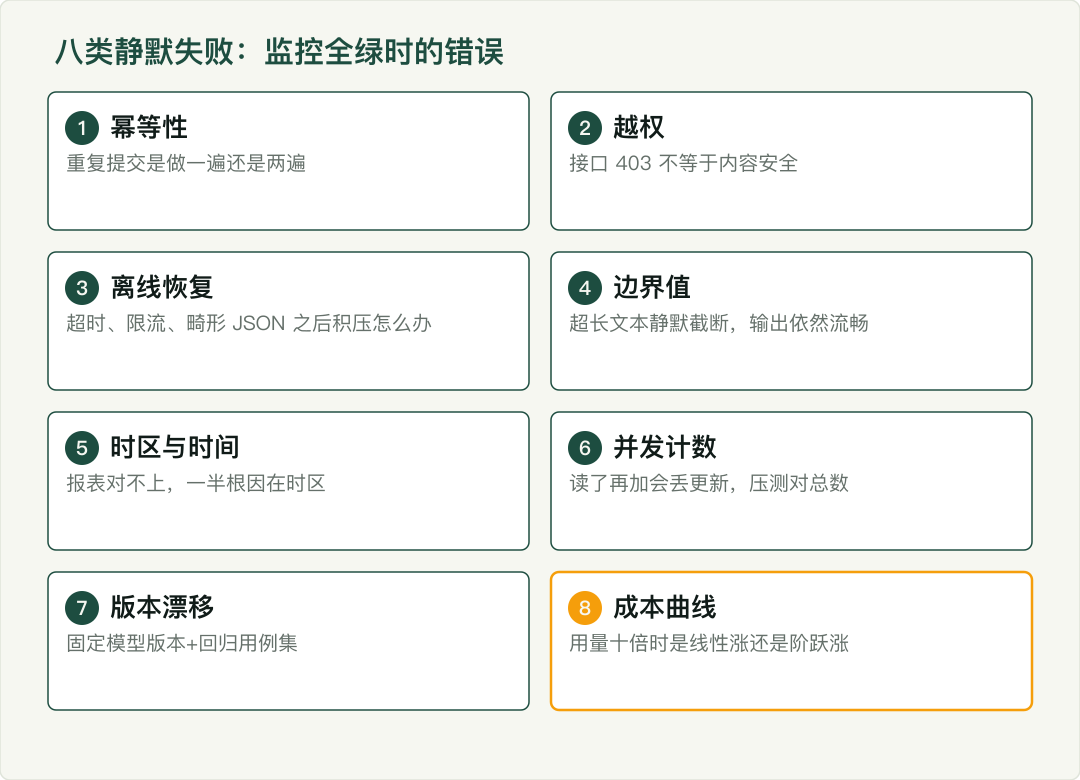
1. 幂等性。 同一个请求提交两次(用户手抖、网络重试、消息队列重投),结果是做了一遍还是两遍?"一遍"和"两遍"在计费、库存、通知场景里是天壤之别。
2. 越权。 A 用户能否通过改请求参数读到 B 用户的数据?模型输出里会不会带出提示词里不该出现的上下文?权限测试必须带数据面做,接口 403 不等于内容安全。
3. 离线恢复。 依赖的外部模型服务超时、限流、返回畸形 JSON——系统是排队重试、降级兜底,还是把脏数据写进库?断网一小时再恢复,积压的处理正确吗?
4. 边界值。 空输入、超长输入、全特殊字符、恰好等于阈值的记录数。AI 系统的边界还包括 token 上限——超长文本被静默截断后,输出看起来依然流畅,这是最隐蔽的一类。
5. 时区与时间。 统计口径按 UTC 还是本地时间?跨日任务在夏令时切换那天跑几次?报表数字对不上,一半的根因在时区。
6. 并发计数。 点赞、库存、额度这类"读了再加"的操作,并发下会丢更新。压测时专门测同一资源的高频并发写,对一下总数。
7. 版本漂移。 模型提供方悄悄升级了版本,同样的输入输出变了。验收时要固定住模型版本并留下回归用例——每次变更跑一遍,不然"上线时是对的"这句话毫无意义。
8. 成本曲线。 单请求成本 × 预期峰值流量,算过吗?用量翻十倍时成本是线性涨还是阶跃涨(缓存命中率掉下来那类阶跃)?上线一个月收到十倍账单的项目,验收时都只测了功能没测曲线。
不必八类全建自动化,但每一类要有一个当场可做的动作:手工构造一次重复提交、换一个用户的 token 调一次接口、把输入拉到超长看输出是否被截断。半天时间能过一遍,比任何验收报告都实在。
静默失败的共同点是:出问题时,所有你监控的东西都显示绿色。验收测的不是"功能对不对",是"错的时候你看不看得见"。
撰稿:邓湘雷
发布于
2026-10-20
更新于
2026-10-23
类目
作者
晓黎团队
版权协议